DeepSeek 同一批请求,账单少七成
9 月 10 日,DeepSeek 把一封信塞进了每个 API 用户的邮箱:v4.1 Flash 上线,四天后,所有发给 deepseek-v4-pro 的请求会被强制路由过去,按 Flash 的价格收费。
9 月 10 日,DeepSeek 把一封信塞进了每个 API 用户的邮箱:v4.1 Flash 上线,四天后,所有发给 deepseek-v4-pro 的请求会被强制路由过去,按 Flash 的价格收费。
HN 上那条讨论帖,五天里攒了 1011 分、576 条评论。有意思的是,评论区的焦点不在"新模型多强",而在两件更小的事:它到底有多便宜,以及自己手头的机器能不能跑。
这篇只算第一件事。你的账单结构,在这一周里被整个重排了。
先看那张没人细看的价格表
DeepSeek 官方定价页(api-docs.deepseek.com/quick_start/pricing)在 9 月 10 日之后已经换血。写完这篇文章时,页面缓存里还能看到旧表残留,但生效的新价目是:
| 计费项 | v4-pro(已路由消失) | v4.1-flash(现价,非峰) |
|---|---|---|
| 输入 / 缓存命中 | $0.022 / 1M | $0.003 / 1M |
| 输入 / 缓存未命中 | $0.66 / 1M | $0.15 / 1M |
| 输出 | $1.98 / 1M | $0.60 / 1M |
| 并发上限 | 500 | 2500 |
非峰窗口是 UTC 01:00–04:00 和 06:00–10:00 之外的时间(工作日),价格减半。
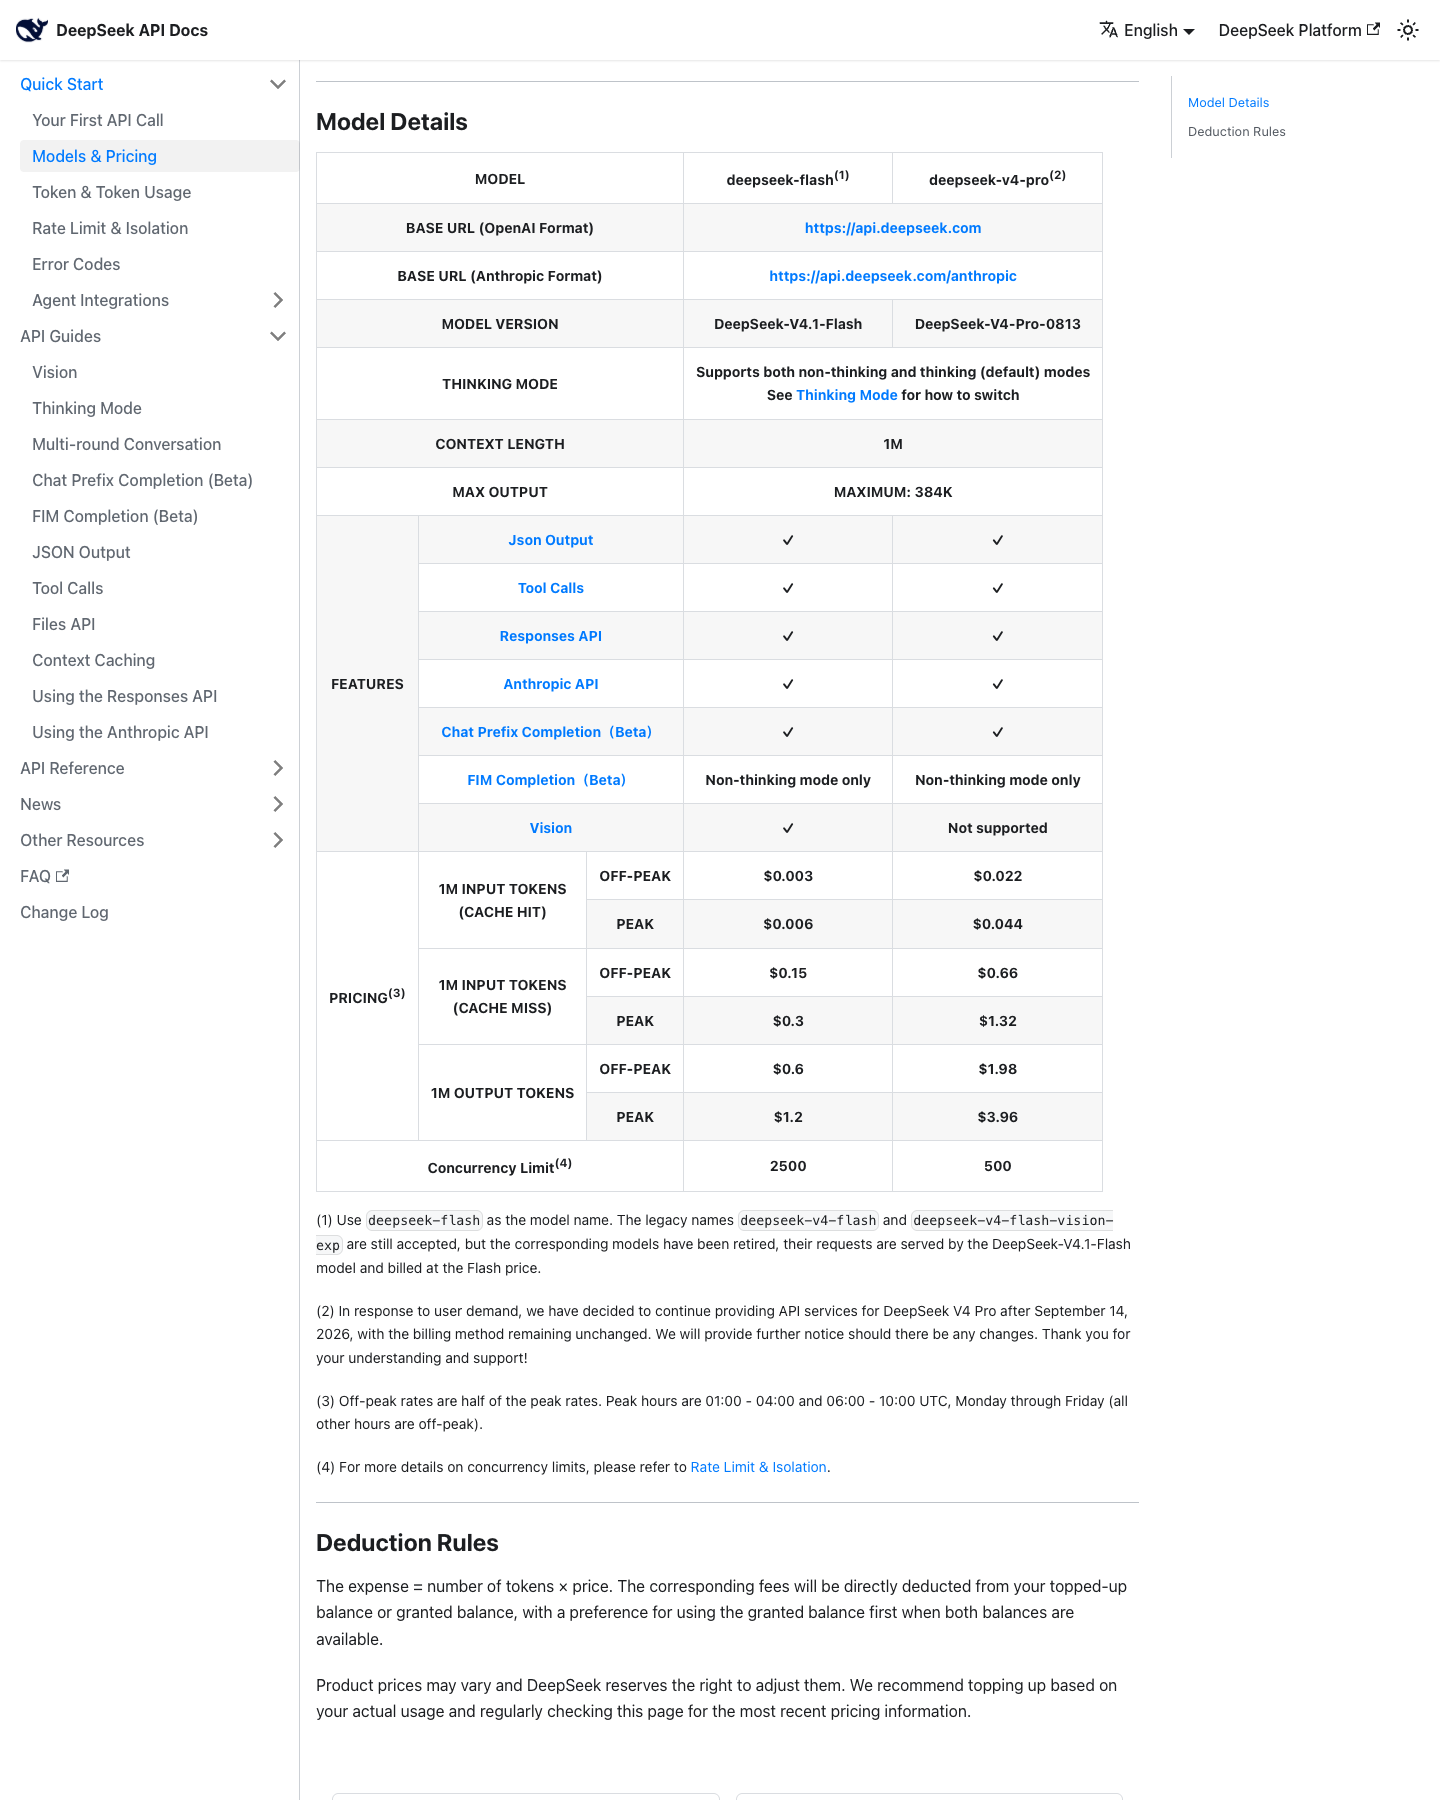
四行数字,两个结论:
第一,缓存命中输入从 $0.022 降到 $0.003,是 7.3 倍。注意旧 v4-flash 的命中价是 $0.007——新架构把"重复发送的系统提示词、工具 schema、知识片段"这一档打成接近于零。eesel 那篇定价分析的说法是"比未命中便宜 50 倍",这是第一张表里最值钱的信号。
第二,输出从 $1.98 降到 $0.60,是 3.3 倍。输出历来是大头。9 月 14 日中午之后,你根本不用改代码——只要你的代码里还写着 deepseek-v4-pro,后端已经在按 $0.60 这一档给你出账。
用我自己的用量算一遍
拿一个我自己的真实场景:InsightNxt 的亚马逊评论批量分析。
这个模块的形态很典型:每天一次批处理,每条任务的输入大约 8K tokens(其中 7K 是固定的 prompt 模板 + schema,不到 1K 是真的评论原文),输出 800 tokens 左右的结构化 JSON。一天大约 2000 条任务。
如果跑在非峰窗口,一个月(30 天)的账:
按 v4-pro 旧价:
- 输入未命中部分:8K × 2000 × 30 = 480M tokens × $0.66 = $317
- 输出部分:800 × 2000 × 30 = 48M tokens × $1.98 = $95
- 合计约 $412/月。这还没算缓存命中收益(v4-pro 时代我几乎没做 prefix 缓存,因为 $0.022 的命中价省不了几个钱)。
按 v4.1-flash 现价(非峰):
- 输入未命中:因为 7K/8K 的 prompt 是固定的,只要调度器把同模板请求排在一起,命中率可以做到很高。保守按 80% 命中算:
- 命中部分:480M × 0.8 × $0.003 = $1.2
- 未命中部分:480M × 0.2 × $0.15 = $14.4
- 输出:48M × $0.60 = $28.8
- 合计约 $44/月。
$412 → $44。差不多九成。哪怕完全不碰缓存、按全未命中算,也是 480M × $0.15 + 48M × $0.60 ≈ $101,还是旧价的四分之一。
这个场景下,价格表里那个"缓存命中 $0.003"不是装饰数字——它等于在告诉你:你那个懒得做 prefix 缓存的批处理,现在做一次缓存设计的回报率是过去的 7 倍。
账单上有三个不写在价格表里的新变量
价格表只告诉你单价。真实账单会被三件事重新塑形。
1. 峰/非峰第一次变得值得调度
peak 是 $0.30 输入 / $1.20 输出,非峰正好一半。按我上面的用量:全跑在非峰约 $44,全跑在峰值约 $88。一个月差 $44。
这个绝对值不大,但比值是 2:1。以前所有的模型调度策略里,"几点跑批"从来不进成本公式——现在它进了。UTC 01:00–04:00 和 06:00–10:00 是峰,对应北京时间 09:00–12:00 和 14:00–18:00。也就是说,你在工作时间跑批,付的是双倍价;挂到凌晨的 cron 跑,自动半价。
Daily collect 的采集任务、InsightNxt 的评论批处理,过去都挂在凌晨三点,纯属巧合踩在了非峰。现在这条巧合值得写进运维文档,变成显式策略。
2. reasoning effort 是一个 1-100 的成本旋钮
v4.1 Flash 原生支持一个连续可调的推理强度参数,1 到 100。所有官方 benchmark 都是在 effort=100、max 档下跑的——那是它"超过 V4 Pro"的成绩单。但日常大部分任务根本用不到 100。
eesel 的分析里点了一句很实在的:默认 thinking 模式开着,reasoning tokens 全部按输出价计费。一条返回 200 token 答案的请求,背后可能烧了几千 token 的隐藏推理。你要是不调,你按 $0.60/1M 算的"输出预算"可能差一个数量级。
反过来,这也是机会:Tier-1 客服分流、评论标签这类低推理任务,把 effort 压到 10-20,成本可以贴着标题价走;硬任务再上 80-100。同一个端点,可以当两个价位的模型用。
3. 本地部署的近似成本也变了
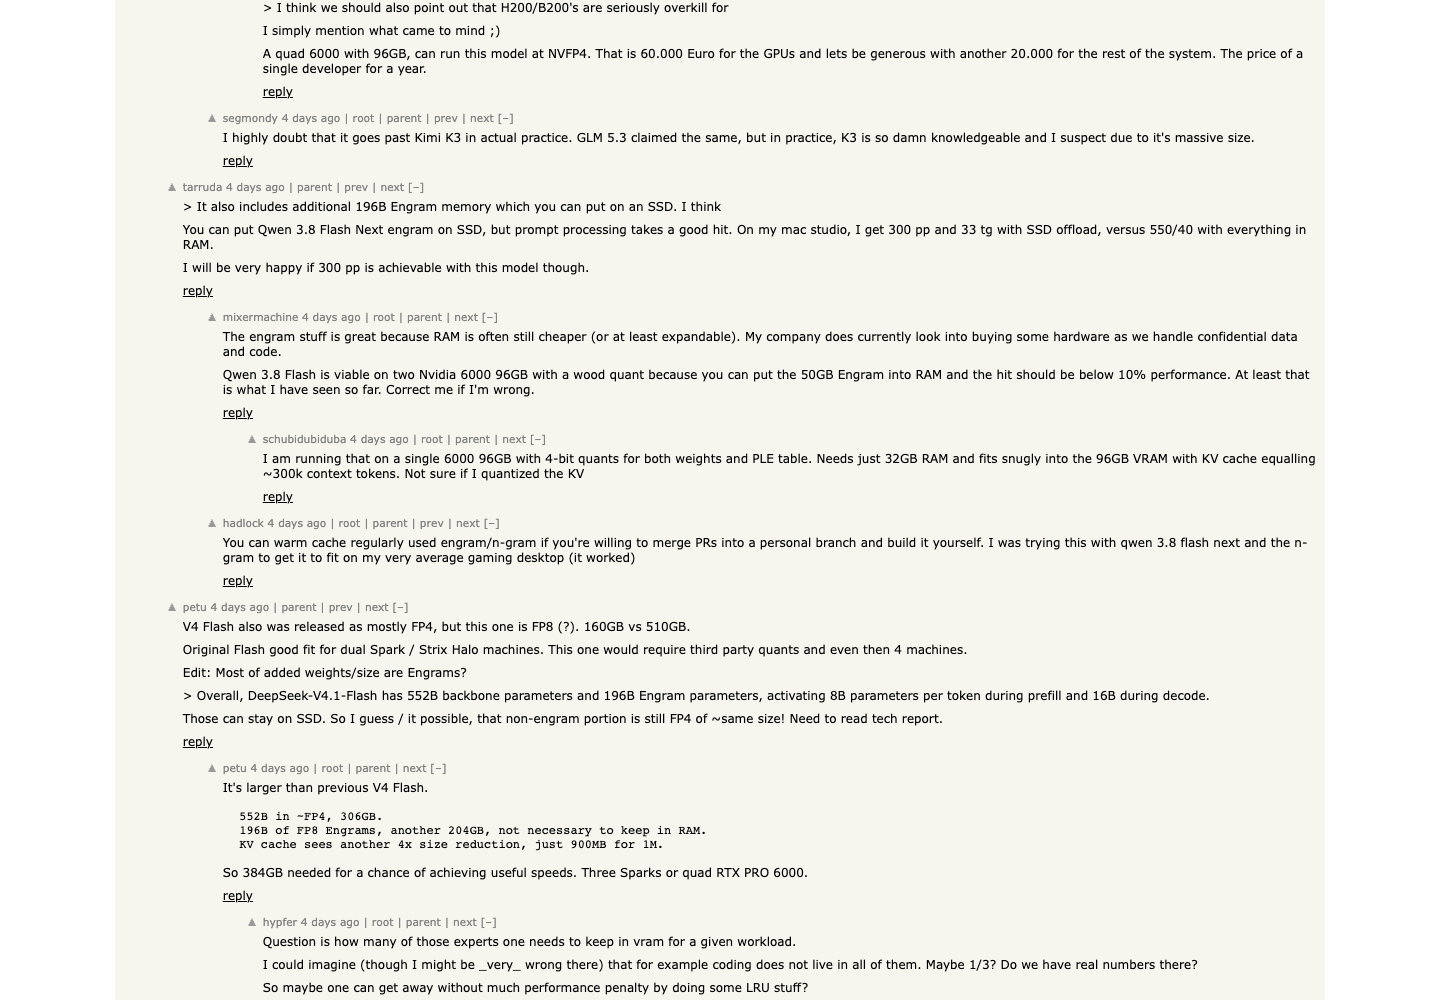
HN 576 条评论里,最热门的那条也是在算账——petu 贴的明细:
552B in ~FP4, 306GB.
196B of FP8 Engrams, another 204GB, not necessary to keep in RAM.
KV cache sees another 4x size reduction, just 900MB for 1M.
结论:想跑出像样的速度,大约需要 384GB 显存——"三块 Spark 或者四卡 RTX PRO 6000"。另一位 mixermachine 回帖说他已经在单块 6000 96GB 上用 4-bit 量化 + 32GB 内存跑起来了,代价是 KV cache 只剩约 30 万 token 的上下文。
对绝大多数人,这仍然不是"家里能跑"的模型。但它把门槛从"一百万的机房"压到了"一台开发者年薪的工作站"——benjiro29 在帖子里算的是 €80,000,正好约等于一名开发者一年的成本。自部署什么时候划算的问题,第一次有了可以认真算的表。
别急着庆祝:两个还没兑现的东西
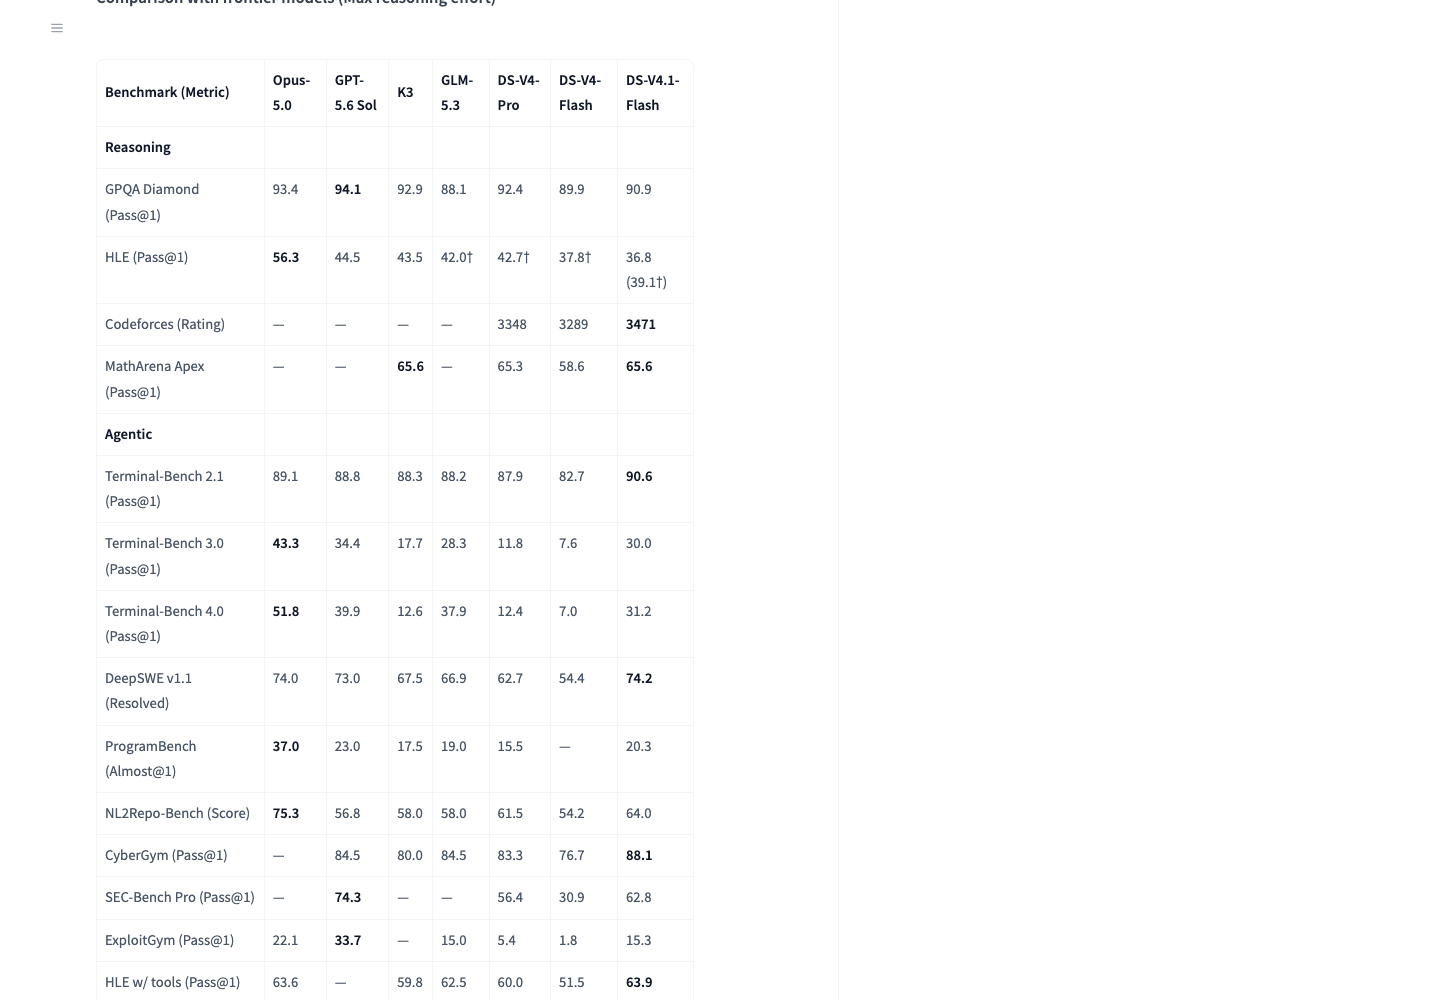
DeepSeek 官方的说法是多家测试表明 v4.1 Flash 在性能、成本、速度、总耗时四个维度全面超过 V4 Pro。但 orcarouter 那篇跟踪文章(9/10)指出一个值得记住的细节:发布当天,Artificial Analysis 还没有给出独立测量,Hugging Face 页面上还挂着"未被任何推理服务商部署"的标签。"入门款打赢上一代 1.6T 旗舰"这个说法,目前是厂商口径,没有第三方审计。
模型卡里那张对比表也印证了这一点:Terminal-Bench 2.1、DeepSWE、CyberGym、AutomationBench,v4.1 Flash 确实领先 Opus-5.0 和 GPT-5.6 Sol;但 Terminal-Bench 3.0/4.0、ProgramBench、SEC-Bench Pro,Opus/GPT 仍然在前面。它赢在"老一代的编码 harness",还没赢下"新一代的难任务"。 如果你 agent 体系的瓶颈恰好在新难任务上,别看到 7 折价格就立刻全迁——先跑自己的 eval。
读者动作清单
以下每件事都能在 30 分钟内做完:
-
全局搜你的硬编码。
git grep -E '"deepseek-(v4-pro|v4-flash)"'——这个字符串现在指向的是新模型、新价格。把 model name 挪进环境变量里最省事;顺带按照 9/14 那篇的清单核一遍 eval 基线(那篇管"模型是谁",这篇管"账单多少",两步缺一不可)。 -
把你 9 月的批处理账单导出,按新价目重算一遍。输入命中/未命中拆开、输出单列、标注请求发生在峰还是非峰。如果每月量级在百万 token 以上,"把批任务挪到非峰 + 打开 prefix 缓存"这两件事的回报,大概率比你最近任何一个 prompt 优化都大。
-
选 3 条核心 prompt,测一次 reason effort 的价格-质量曲线。同一条任务,effort=20 和 effort=100 各跑三次,记录输出 token 数和答案质量。你的账单上很可能藏着一个"五倍推理费换 2% 质量"的旋钮,把它找出来。
-
非峰调度显式化。打开你的 crontab 或 job scheduler,确认批任务的运行窗口落在 UTC 04:00–06:00 或 10:00–次日 01:00(工作日),并把这个约束写进 README——否则下次有人把任务挪到"白天方便看日志",你的账单会静默翻倍。
最后
我九月刚开始用这套新的成本结构重算 InsightNxt 的月度账单时,第一反应是"是不是哪里算错了"。
没算错。输入便宜了 4.4 倍,输出便宜了 3.3 倍,缓存命中便宜了 7 倍,并发翻了五倍——这四个数字乘在一起,就是"同一批请求,账单少七成"。
这次真正值得记住的不是"DeepSeek 又降价了",而是成本模型第一次变成了可以主动设计的东西:缓存放哪、几点跑批、推理开多大、什么任务用什么模型档。这张表的每一个维度,都是一个旋钮。过去这些旋钮锁在厂商手里;这一周开始,有一半被递到了你手上。
会用的人,账单会继续降。不会用的人,只是被动收到了一张七折券——然后在明年模型换代的时候,再一次发现账单整体重排,而自己连旋钮在哪都不知道。
—— 完 ——
数据来源(备查,不进正文):
- 官方公告:api-docs.deepseek.com/news/news260910(9/10 发布;9/14 04:00 UTC 起 v4-pro 强制路由;非峰=峰半价)
- 官方定价页:api-docs.deepseek.com/quick_start/pricing(r.jina.ai 缓存与 web 搜索摘要双源核验;v4-pro: $0.022/$0.66/$1.98 非峰;v4.1-flash: $0.003/$0.15/$0.60 非峰)
- HF 模型卡:huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash(CED 架构、8B/16B 激活、890B/token KV cache、frontier 对比表、MIT)
- HN 主帖:news.ycombinator.com/item?id=49639090(Algolia 核验 1011 分 / 576 comments / 2026-09-10;petu 显存明细、mixermachine 6000 单卡实测、benjiro29 €80k 成本类比)
- HN 预热帖 49624603:417 分 / 218 评论(含 DeepSeek 官方通知原文与价格生效时间)
- 第三方分析:eesel.ai/blog/deepseek-v4-1-flash-pricing(峰/非峰窗口、reasoning token 计费陷阱、缓存命中 50 倍价差);deepinfra.com/deepseek-ai/DeepSeek-V4.1-Flash(第三方托管价 $0.20/$0.60,并发佐证)
- 审慎来源:orcarouter.ai/blog/deepseek-v4-1-new-base-model(发布当日无 Artificial Analysis 独立测量、HF"未部署"标签)